Så prissätter AI Champions Leagues ligafas
En AI-modell värderar Champions Leagues ligaspel med hjälp av koefficienter, form, truppstyrka, hemmafördel och resor.
Lottningen till Champions League 2026–27 är mer än bara en lista på motståndare. Det är ett spelschema med åtta matcher som måste omvandlas till sannolikheter, förväntade poäng och vägar till avancemang. I den nya ligafasen med 36 lag möter varje klubb två lag från var och en av fyra seedningsgrupper, med fyra hemmamatcher och fyra bortamatcher. En modell, likt den som används i ScorePoint AI:s analysverktyg, skulle först prissätta varje enskild match för att sedan simulera hela tabellen tusentals gånger.
Så fungerar Champions League-lottningen
Formatet skapar en enda ranking från 1 till 36, istället för åtta grupper med fyra lag. De åtta främsta kvalificerar sig direkt till åttondelsfinal. Lag som hamnar på plats 9 till 16 går vidare till playoff-rundan som seedade lag, medan platserna 17 till 24 också når playoff som osedade lag. De tolv nedersta lagen elimineras.
Den här strukturen förändrar innebörden av en lottning. En klubb behöver inte vinna varje svår match, men den måste undvika ett spelschema som ger för många bortamatcher med låg sannolikhet. Modellen mäter därför mer än ett lags genomsnittliga styrka. Den estimerar fördelningen av möjliga poäng mot alla åtta motståndare och identifierar om ett lags sannolika slutplacering är koncentrerad kring 7:e, 12:e eller 20:e plats.
Från seedningsgrupper till sannolikheter
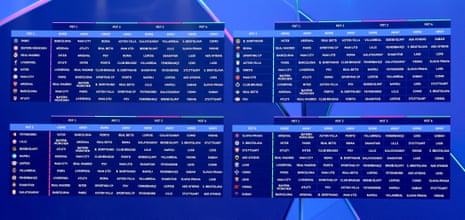
Den första inputen är långsiktig styrka. UEFA:s koefficientranking är användbar eftersom den fångar upp europeisk prestation över flera säsonger och hjälper till att bestämma placering i seedningsgrupperna. Den projektion som gäller för 2026–27 placerar Arsenal, Manchester City, Liverpool, Real Madrid, Barcelona och Atlético Madrid i Grupp 1, tillsammans med regerande mästarna Paris Saint-Germain, Bayern München och Inter Milan. Arsenals kliv förbi Borussia Dortmund i koefficientlistan är ett tydligt exempel på hur seedning kan påverka svårighetsgraden i ett lags spelschema.
Koefficientstyrka kan dock inte användas som en slutgiltig bedömning. Det är en utgångspunkt, inte en komplett prognos. En modell skulle kombinera den med motståndaranpassad inhemsk och europeisk form, med hänsyn till kvaliteten på de lag som mötts. En 3–0-seger mot ett bottenlag i ligan bör påverka rankingen mindre än en 2–1-seger borta mot en topprival. Samma princip gäller för dåliga resultat: en förlust mot en toppmotståndare är mindre skadlig än att tappa poäng mot ett lägre rankat lag.
Truppkvalitet lägger till ett framåtblickande lager. Modellen skulle bedöma djupet och den förväntade bidragningen från den tillgängliga truppen, istället för att enbart förlita sig på fjolårets resultat. Det är särskilt viktigt efter VM 2026, då spelarnas arbetsbelastning och rotation kan påverka prestationer på matchnivå avsevärt. Den offentliga lottningsinformationen ger inte bekräftade startelvor, skadelistor eller spelartillgänglighet, så dessa variabler bör förbli justerbara snarare än att presenteras som fasta fakta.
Hemmafördel och resor
Hemmafördel är inte en fast poängbonus som tillämpas identiskt på alla åtta matcher. Den bör variera beroende på arena, motståndare och matchkontext. En modell skulle uppskatta hur mycket ett lags prestation hemma förbättrar dess vinstsannolikhet, och sedan tillämpa en mindre eller negativ justering när samma lag reser till en svår bortastadion.
Resor spelar också roll, även om det bör hanteras försiktigt. Avstånd, tidsskillnader, återhämtningsdagar och sekvensen av hemma- och bortamatcher kan påverka förberedelserna. Fyra bortamatcher utspridda över schemat kan vara hanterbara; fyra långa resor packade på kort tid kan minska den förväntade prestationen. Resekomponenten bör därför ingå i matchbedömningen som en blygsam justering, inte som en avgörande förklaring till varje resultat.
Lottningsbegränsningar måste kodas innan simulering. Klubbar kan inte möta ett lag från samma land, och ligaspelsreglerna begränsar lag från att möta fler än två motståndare från samma nation. Dessa restriktioner innebär att det matematiskt svåraste möjliga schemat inte alltid är ett juridiskt giltigt sådant. Därför måste en korrekt lottningsanalys endast simulera giltiga spelscheman, snarare än att rangordna motståndare isolerat.
Från matchpriser till kvalificering
När varje match har en sannolikhet för hemmavinst, oavgjort och bortavinst, omvandlar modellen dessa utfall till förväntade poäng. Den simulerar sedan hela tabellen med 36 lag, inklusive effekterna av målskillnad som tie-breaker genom en modell för poänggenerering. De användbara utfallen är inte en enskild förutsagd position, utan ett intervall: sannolikhet att sluta topp åtta, sannolikhet att nå topp 24 och sannolikhet för eliminering.
- Toppåtta-sannolikhet: det tydligaste måttet på om en klubb kan undvika playoff-rundan.
- Topp-24-sannolikhet: den praktiska överlevnadsprognosen under ligaspelsformatet.
- Förväntade poäng: ett schema-justerat estimat av total poängskörd i ligafasen.
- Lottningssvårighet: skillnaden mellan ett lags projicerade poäng och dess prognos under en genomsnittlig, giltig lottning.
Detta ramverk förklarar också varför Manchester Uniteds projicerade placering i seedningsgrupperna har väckt uppmärksamhet: en lägre seedning garanterar exponering för starkare motståndare, redan innan det exakta spelschemat är känt. Den korrekta analysen är inte att en svår lottning gör kvalificering omöjlig. Det är att lagets sannolikhetsfördelning blir bredare, med färre lågrisk-matcher tillgängliga för att bygga en poänggrund.
Praktisk Champions League-överblick
Den bästa lottningsförhandlingen kommer därför att skilja rykte från spelschemavärde. Paris Saint-Germain går in som regerande mästare, medan Arsenal, Barcelona, Bayern München och Real Madrid identifieras bland de ledande utmanarna, men elitstatus ger inte automatiskt en toppåtta-väg. Jämvikt i arenor, motståndaranpassad form och resor kan flytta ett lag flera förväntade poäng.
Efter lottningen är den mest användbara frågan inte “Vem fick den svåraste motståndaren?”. Det är “Hur många giltiga simuleringar resulterar i ett toppåtta-, topp-24- eller elimineringsutfall?”. Det är det centrala värdet av datadriven Champions League-analys, och det ger en mer praktisk prognos än att behandla den automatiska lottningen som en enkel lista över berömda namn. För ytterligare kontext, se analysen av de tuffaste Champions League-lottningarna och analysen av tidiga resultat – signal eller brus.
Forskningsreferenser
Dessa källor granskades under förberedelsen av denna ScorePoint AI-analys.